Blog
Automatyzacja dokumentów w firmie: faktury, oferty, umowy, PDF-y i e-maile z AI
Jak zautomatyzować dokumenty w firmie? Zobacz proces dla faktur, umów, ofert, PDF-ów i e-maili: OCR, AI, walidacja, KSeF, ERP i CRM.
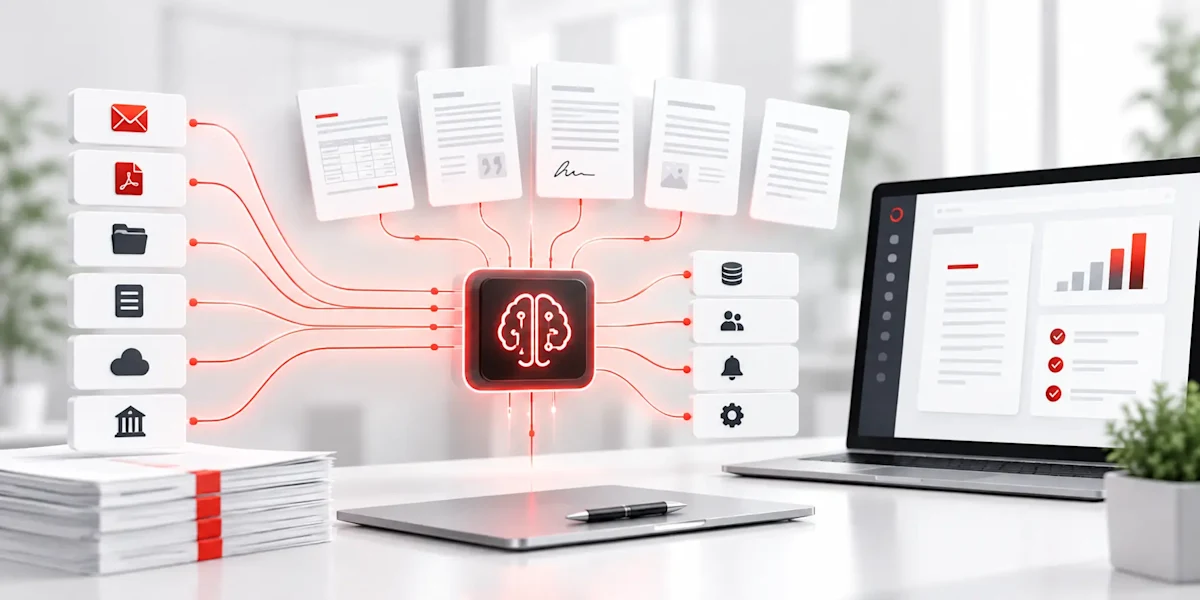
Automatyzacja dokumentów w firmie — jak może wyglądać cały proces?
Najprostszy model:
dokument → człowiek → przepisanie danych → system
Dojrzalszy:
dokument → rozpoznanie typu → odczyt → ekstrakcja danych → walidacja → decyzja → ERP / CRM / DMS → akcja → archiwizacja
Jeżeli dokument przychodzi e-mailem:
e-mail → załącznik → klasyfikacja → dokument → ekstrakcja → walidacja → system → odpowiedź / zadanie
Jeżeli jest fakturą z KSeF:
KSeF API → dane strukturalne → walidacja biznesowa → system księgowy / ERP → workflow
W wielu przypadkach dokument nie powinien kończyć jako:
ładnie nazwany PDF w folderze.
Powinien uruchamiać:
proces.
Faktura → weryfikacja → księgowość → akceptacja → płatność.
Umowa → wydobycie terminów → CRM → zadanie → przypomnienie.
Zapytanie ofertowe → analiza wymagań → CRM → zadania → draft oferty.
To jest prawdziwa:
automatyzacja dokumentów.
---
OCR to dopiero początek
Przez lata automatyzacja dokumentów kojarzyła się głównie z:
OCR — Optical Character Recognition.
OCR odpowiada przede wszystkim na pytanie:
„jaki tekst znajduje się na obrazie lub skanie?”
Nowoczesne systemy document AI idą dalej.
Potrafią:
- rozpoznawać strukturę,
- wykrywać tabele,
- identyfikować klucze i wartości,
- klasyfikować typ dokumentu,
- rozdzielać wielodokumentowe PDF-y,
- wydobywać konkretne pola,
- normalizować wartości,
- analizować znaczenie treści.
Google definiuje Document AI właśnie jako przekształcanie nieustrukturyzowanych dokumentów w dane strukturalne nadające się do dalszego użycia w systemach biznesowych. Platforma obsługuje m.in. OCR, klasyfikację, rozdzielanie dokumentów, ekstrakcję danych i analizę layoutu.
AWS opisuje podobny model jako Intelligent Document Processing, łączący OCR, computer vision, NLP, machine learning i generatywne AI.
Dlatego:
OCR ≠ automatyzacja dokumentów.
OCR jest jednym z:
elementów pipeline’u.
---
Czym jest Intelligent Document Processing — IDP?
Intelligent Document Processing to proces zamiany:
PDF-ów,
DOCX,
skanów,
zdjęć,
formularzy,
innych dokumentów
na:
ustrukturyzowane dane, które mogą zasilać dalsze aplikacje i procesy.
Microsoft opisuje IDP jako konwersję nieustrukturyzowanej zawartości dokumentowej do uporządkowanych, wzbogaconych danych używanych później przez aplikacje, analitykę i agentów.
W praktyce pipeline IDP może wyglądać:
plik → OCR / parsing → klasyfikacja → ekstrakcja → walidacja → human review → system docelowy
AI może zostać dodane tam, gdzie klasyczny parser nie wystarcza.
---
Trzy rodzaje dokumentów, które trzeba rozróżnić
To bardzo ważne przed wyborem technologii.
Dokumenty ustrukturyzowane
Układ jest praktycznie zawsze taki sam.
Przykład:
formularz firmowy,
standardowy raport,
własny szablon.
Łatwo automatyzować je:
regułami
i:
klasyczną ekstrakcją.
Dokumenty półustrukturyzowane
Informacje są podobne, ale layout się zmienia.
Najlepszy przykład:
faktura.
Każdy dostawca może posiadać inny wygląd.
Ale prawie zawsze szukamy:
numeru,
daty,
sprzedawcy,
nabywcy,
kwot,
VAT,
terminu,
pozycji.
Tu bardzo dobrze sprawdzają się:
modele dokumentowe.
Dokumenty nieustrukturyzowane
Przykład:
umowa,
zapytanie ofertowe,
pismo,
długi e-mail,
specyfikacja.
Nie wystarczy znaleźć:
„pole nr 3”.
Trzeba:
zrozumieć treść.
I właśnie tutaj generatywne AI może dawać największą wartość.
Microsoft również rozdziela przetwarzanie dokumentów strukturalnych i półstrukturalnych, takich jak faktury, od dokumentów swobodnych, takich jak listy i umowy.
---
Uniwersalny proces automatyzacji dokumentów
Niezależnie od typu dokumentu warto myśleć w kilku etapach.
1. Wejście
Skąd dokument przychodzi?
E-mail?
KSeF?
Formularz?
Folder?
Drive?
SharePoint?
SFTP?
ERP?
2. Identyfikacja
Co to za dokument?
Faktura?
Umowa?
Oferta?
CV?
Reklamacja?
3. Przygotowanie
Czy plik:
jest czytelny?
ma hasło?
jest skanem?
zawiera wiele dokumentów?
4. Odczyt
OCR / parser.
5. Ekstrakcja
Których danych potrzebujemy?
6. Walidacja
Czy wartości są:
poprawne,
kompletne,
zgodne?
7. Kontekst biznesowy
Czy dostawca istnieje?
Czy numer zamówienia jest prawidłowy?
Czy umowa istnieje w CRM?
8. Decyzja
Automatycznie?
Human review?
Eskalacja?
9. Zapis
ERP?
CRM?
DMS?
Baza?
Arkusz?
10. Kolejne działanie
Zadanie.
Akceptacja.
Płatność.
Follow-up.
Powiadomienie.
---
1. Automatyzacja faktur
To jeden z najbardziej naturalnych procesów dokumentowych.
Klasyczny model:
faktura przychodzi e-mailem → pracownik otwiera PDF → czyta → przepisuje numer → przepisuje datę → NIP → kwotę → termin → opis → ERP → folder.
Przy:
10 fakturach miesięcznie
problem może być mały.
Przy:
1000
staje się procesem operacyjnym.
---
Co można automatycznie odczytać z faktury?
W zależności od rozwiązania między innymi:
- numer faktury,
- data wystawienia,
- sprzedawca,
- nabywca,
- adres,
- numer identyfikacyjny,
- kwota netto,
- VAT,
- brutto,
- waluta,
- termin płatności,
- pozycje,
- ilości,
- ceny jednostkowe.
Microsoft Document Intelligence posiada gotowy model faktur wykorzystujący OCR i ekstrakcję pól oraz pozycji, zwracający dane w ustrukturyzowanej formie.
Amazon Textract również posiada specjalizowany proces dla faktur i rachunków, który potrafi wydobywać między innymi dostawcę, datę dokumentu, numer, pozycje, sumę i warunki płatności bez konieczności budowania szablonu dla każdego layoutu.
---
Ale w Polsce w 2026 faktura PDF nie zawsze powinna być źródłem danych
To bardzo ważne.
Wraz z obowiązkowym KSeF 2.0 część firm może pozyskiwać dane dotyczące faktur bezpośrednio z:
ustrukturyzowanej faktury elektronicznej.
Ministerstwo Finansów udostępnia API KSeF 2.0 z dokumentacją OpenAPI umożliwiającą integrację systemów finansowo-księgowych z KSeF.
Jeżeli dane są dostępne jako:
struktura XML / dane API,
to odczytywanie ich później z:
PDF-a poprzez OCR
jest często niepotrzebnym dodatkowym krokiem.
---
KSeF 2026 — co to zmienia w automatyzacji faktur?
Na 20 września 2026 roku obowiązek wygląda następująco:
od 1 lutego 2026 r.
KSeF obowiązuje dla największych podatników, których sprzedaż brutto w 2024 r. przekroczyła 200 mln zł.
od 1 kwietnia 2026 r.
obowiązek wystawiania objął pozostałych przedsiębiorców, z wyjątkiem czasowego odstępstwa dla najmniejszych podmiotów o sprzedaży dokumentowanej fakturami nieprzekraczającej 10 tys. zł brutto miesięcznie.
od 1 stycznia 2027 r.
KSeF ma objąć również tę najmniejszą grupę.
Odbieranie faktur przy użyciu KSeF jest obowiązkowe już od:
1 lutego 2026 r.
To oznacza, że architektura automatyzacji faktur w polskiej firmie powinna już uwzględniać:
KSeF jako potencjalne źródło danych.
---
Przykład automatyzacji faktury z KSeF
KSeF → pobranie faktury → sprawdzenie dostawcy → sprawdzenie zamówienia → walidacja kwot → ERP → approval → termin płatności → archiwizacja
Tutaj:
OCR może w ogóle nie być potrzebny.
---
Kiedy OCR faktury nadal będzie potrzebny?
Nie wszystkie dokumenty w firmie pochodzą z KSeF.
Możesz nadal otrzymywać:
dokumenty zagraniczne,
załączniki,
proformy,
rachunki,
skany,
inne dokumenty księgowe.
Wtedy pipeline może wyglądać:
e-mail → załącznik → rozpoznanie typu → OCR / AI → ekstrakcja → walidacja → ERP
Najlepsza architektura nie mówi więc:
„wszystkie faktury przez OCR”.
Mówi:
„wybierz najlepsze źródło danych dla danego typu dokumentu”.
---
Automatyzacja faktury nie kończy się na OCR
Załóżmy:
system odczytał:
Kwota: 12 300 zł
Świetnie.
Ale dalej trzeba odpowiedzieć:
Czy dostawca istnieje?
Czy faktura nie jest duplikatem?
Czy kwota zgadza się z zamówieniem?
Czy istnieje PO?
Czy numer rachunku jest zgodny?
Czy wymagany jest approval?
Do jakiej kategorii kosztowej przypisać dokument?
Jaki jest termin płatności?
To właśnie tutaj:
document extraction zmienia się w workflow biznesowy.
---
Przykład walidacji faktury
System odczytuje:
Netto: 10 000 zł
VAT: 2300 zł
Brutto: 12 300 zł
Pierwsza kontrola:
10 000 + 2300 = 12 300.
Następnie:
ERP pokazuje PO:
10 000 netto.
Zgadza się.
Dostawca:
istnieje.
Numer faktury:
nie istnieje wcześniej.
Status:
gotowa do akceptacji.
Jeżeli jedna wartość się nie zgadza:
human review.
Google Document AI rozwija również mechanizmy walidacji, które mogą np. sprawdzać zgodność sum pozycji z wartością całkowitą albo spójność pól dokumentu.
---
2. Automatyzacja faktur otrzymywanych e-mailem
Typowa skrzynka:
`faktury@firma.pl`
otrzymuje:
PDF,
PDF + XML,
proformę,
przypomnienie,
umowę,
spam.
Automatyzacja może działać:
nowy e-mail → załączniki → klasyfikacja → dokument
Jeżeli:
faktura → proces księgowy.
Jeżeli:
proforma → inny workflow.
Jeżeli:
umowa → legal.
Jeżeli:
brak załącznika → powiadomienie / review.
---
AI powinno rozumieć e-mail i dokument osobno
Nadawca pisze:
Dzień dobry, przesyłam korektę faktury nr FV/102/26. Poprzedni dokument proszę zignorować.
Załącznik:
PDF.
Jeżeli system analizuje tylko:
PDF,
może nie zrozumieć:
kontekstu.
Dlatego w wielu workflow warto przetwarzać:
e-mail + załącznik.
E-mail dostarcza:
kontekst.
Dokument:
dane formalne.
---
3. Automatyzacja ofert
Firma otrzymuje zapytanie:
PDF.
Excel.
E-mail.
Specyfikację.
Pracownik musi ustalić:
czego klient chce?
jakie są wymagania?
jaki termin?
jakie ilości?
jakie załączniki?
czy spełniamy warunki?
Można znacząco skrócić ten proces.
---
Przykład: zapytanie ofertowe
Klient przesyła:
18-stronicowy PDF.
AI może wydobyć:
Klient: ABC S.A.
Przedmiot: system X
Termin składania oferty: 14 października
Termin realizacji: do końca Q1
Wymagane dokumenty:
- zaświadczenie,
- referencje,
- specyfikacja techniczna.
Wymagania obligatoryjne:
- …
- …
- …
Warunki płatności: …
Kryteria oceny: …
System może następnie:
utworzyć opportunity w CRM,
utworzyć deadline,
przypisać zadania,
powiadomić odpowiednich ludzi.
---
AI nie powinno samo stwierdzać, że firma spełnia każdy wymóg
To kluczowe.
AI może:
wydobyć wymaganie.
Może również:
znaleźć potencjalnie powiązaną informację w bazie firmy.
Ale jeżeli pytanie brzmi:
„Czy spełniamy wymóg prawny X?”
lub:
„Czy możemy podpisać to zobowiązanie?”
często potrzebny jest:
człowiek.
Dobra architektura:
AI identyfikuje → system przypisuje → ekspert zatwierdza.
---
Automatyczne tworzenie checklisty z zapytania ofertowego
To bardzo praktyczny use case.
Z dokumentu powstaje:
- zadanie dla sprzedaży,
- zadanie dla technicznego,
- zadanie dla finansów,
- zadanie dla legal,
- deadline,
- checklista załączników.
Zamiast:
jednej osoby, która pamięta cały dokument.
---
Automatyczne przygotowanie draftu oferty
AI może wykorzystać:
treść zapytania,
informacje z CRM,
katalog usług,
zatwierdzone case studies,
szablon.
Następnie przygotować:
draft.
Człowiek sprawdza:
zakres,
cenę,
termin,
warunki.
AI nie powinno samodzielnie:
wymyślać ceny
ani:
tworzyć zobowiązań niewynikających z systemów firmy.
---
4. Automatyzacja umów
Umowy są zupełnie innym typem dokumentu niż faktury.
Nie chodzi tylko o pola typu:
numer,
data,
kwota.
Istotne mogą być:
strony,
okres obowiązywania,
termin wypowiedzenia,
SLA,
kary,
limity odpowiedzialności,
automatyczne przedłużenie,
obowiązki,
warunki płatności.
Microsoft Document Intelligence posiada np. gotowy model kontraktowy potrafiący wydobywać między innymi strony, jurysdykcję, ID kontraktu i tytuł, przy czym aktualny gotowy model kontraktowy Microsoftu obsługuje obecnie dokumenty anglojęzyczne.
To pokazuje ważną rzecz:
nie każdy gotowy model będzie odpowiedni dla polskiej umowy.
Czasami potrzebujesz:
custom extraction,
LLM,
własnego schematu,
walidacji człowieka.
---
Co AI może wydobyć z umowy?
W zależności od procesu:
Strony
Data podpisania
Data rozpoczęcia
Data zakończenia
Okres wypowiedzenia
Automatyczne odnowienie
Wartość umowy
Waluta
Warunki płatności
SLA
Kluczowe obowiązki
Załączniki
Terminy
Klauzule wymagające review
---
Najbardziej praktyczny use case umów: pilnowanie terminów
Firma podpisuje:
umowę.
PDF trafia:
do folderu.
Po:
11 miesiącach
ktoś odkrywa, że:
termin wypowiedzenia właśnie minął.
Automatyzacja może działać:
nowa umowa → ekstrakcja → data końca → okres wypowiedzenia → CRM / DMS → przypomnienie 90 / 60 / 30 dni wcześniej
To stosunkowo prosty proces o:
bardzo konkretnej wartości.
---
AI nie powinno zastępować prawnika
Może:
podsumować dokument,
wydobyć klauzule,
porównać tekst ze wzorcem,
wskazać różnice,
zbudować checklistę.
Ale przy interpretacji konsekwencji prawnych:
ostateczna odpowiedzialność powinna pozostać po stronie:
kompetentnej osoby.
Automatyzacja dokumentów prawnych najlepiej sprawdza się jako:
narzędzie do triage, ekstrakcji i kontroli procesu.
Nie jako:
autonomiczny prawnik.
---
5. Automatyczne porównywanie umowy ze wzorcem
Firma ma:
standardową umowę.
Klient odsyła:
wersję z poprawkami.
Człowiek musi sprawdzić:
co się zmieniło.
AI może przygotować:
sekcja 5.2 — zmieniono termin płatności z 14 na 30 dni
sekcja 7 — dodano karę umowną
sekcja 9 — usunięto limit odpowiedzialności
sekcja 12 — zmieniono okres wypowiedzenia
Prawnik albo właściciel:
przegląda różnice.
Nie musi:
czytać obu dokumentów linia po linii od zera.
---
6. Automatyzacja PDF-ów
PDF to tylko:
format.
Nie typ procesu.
PDF może być:
fakturą,
umową,
ofertą,
CV,
instrukcją,
raportem,
zamówieniem,
protokołem.
Dlatego pierwszy krok nie powinien brzmieć:
„odczytaj PDF”.
Tylko:
„ustal, czym jest PDF”.
---
Klasyfikacja dokumentu przed ekstrakcją
Przykład.
Folder zawiera:
10 000 plików.
System najpierw klasyfikuje:
faktura,
umowa,
oferta,
zamówienie,
inne.
Dopiero potem uruchamia:
odpowiedni extractor.
Google Document AI udostępnia oddzielne procesory do klasyfikowania typów dokumentów oraz do rozdzielania złożonych plików zawierających kilka dokumentów.
To szczególnie użyteczne, gdy jeden skan zawiera:
kilka logicznych dokumentów.
---
Wielostronicowy PDF może zawierać kilka dokumentów
Przykład:
strony 1–2:
zamówienie.
3–6:
specyfikacja.
7:
zaświadczenie.
8–9:
umowa.
Nie zawsze sensowne jest wysyłanie:
całych 9 stron
do jednego prompta.
Lepszy pipeline:
split → classify → extract właściwym modelem → połącz dane
To poprawia:
kontrolę,
koszt,
jakość.
---
7. Tabele w PDF-ach
To częsty problem.
Cennik.
Zestawienie.
Specyfikacja.
Faktura.
Excel wyeksportowany do PDF.
OCR tekstu to za mało.
Musimy zachować:
wiersze,
kolumny,
nagłówki,
zależności.
Amazon Textract potrafi zwracać strukturę tabel, w tym komórki, scalone pola, nagłówki, stopki i typ tabeli.
Microsoft Document Intelligence również obsługuje ekstrakcję tabel oraz struktury dokumentów.
---
8. Dokumenty zeskanowane
Skan ma dodatkowe problemy:
krzywo,
ciemno,
mała rozdzielczość,
pieczątki,
dopiski,
ręczne podpisy.
Dlatego jakość dokumentu wejściowego:
ma znaczenie.
Nowoczesne OCR potrafi poradzić sobie z bardzo wieloma przypadkami, ale:
„AI przeczyta wszystko”
nie jest dobrą zasadą projektową.
Jeżeli wynik ekstrakcji jest:
niepewny,
system powinien:
skierować dokument do review.
---
9. Dokument cyfrowy nie zawsze potrzebuje OCR
To analogiczny problem jak KSeF.
Jeżeli PDF posiada:
natywną warstwę tekstową,
nie zawsze trzeba:
renderować każdą stronę do obrazu
i:
uruchamiać OCR.
Można wykorzystać:
natywny tekst i layout.
Google Layout Parser obsługuje między innymi PDF, HTML, DOCX, PPTX i XLSX oraz potrafi wydobywać elementy układu i tworzyć kontekstowe fragmenty.
Microsoft również obsługuje analizę tekstu, layoutu i wielu typów plików biurowych.
Zasada
Używaj najczystszego dostępnego źródła danych.
Nie zamieniaj struktury na obraz:
tylko po to, żeby później ją odzyskiwać OCR-em.
---
10. Automatyzacja e-maili z dokumentami
Bardzo dużo procesów dokumentowych zaczyna się od:
skrzynki.
Przykład:
`biuro@`
`faktury@`
`oferty@`
`reklamacje@`
`zamowienia@`
Automatyzacja może analizować:
nadawcę,
temat,
body,
załączniki.
---
Przykład procesu e-mail → dokument
Nowy e-mail.
System:
sprawdza nadawcę.
Pobiera załączniki.
Rozpoznaje:
czy to dokument.
Klasyfikuje:
faktura.
Odczytuje dane.
Sprawdza dostawcę.
Zapisuje dokument.
Tworzy rekord.
Odpowiada:
„Dokument został przyjęty”.
Albo:
przekazuje do review.
---
E-mail może sam zawierać dokument biznesowy
Nie zawsze występuje PDF.
Klient może napisać:
Proszę o przygotowanie oferty na 20 sztuk urządzenia X z dostawą do Katowic w pierwszym tygodniu listopada.
To również jest:
nieustrukturyzowana informacja biznesowa.
AI może wyciągnąć:
Produkt: X
Ilość: 20
Lokalizacja: Katowice
Termin: pierwszy tydzień listopada
System:
tworzy:
zapytanie ofertowe
w:
CRM / ERP.
---
11. Automatyzacja zamówień
Zamówienie może przyjść:
PDF-em.
E-mailem.
Excel-em.
Każdy klient:
inny format.
AI / document processing może wydobyć:
numer PO,
produkty,
ilości,
ceny,
termin,
adres,
uwagi.
Następnie:
porównać z bazą produktów.
---
Najważniejsze przy zamówieniach: nie pozwalaj AI zgadywać SKU
Klient pisze:
„Model Premium XL czarny”.
System ma w ERP:
`PRM-XL-BLK`.
AI może zasugerować:
dopasowanie.
Ale przed utworzeniem zamówienia dobrze mieć:
deterministyczny mapping
albo:
kontrolę niepewnych przypadków.
W przeciwnym razie jedna kreatywna interpretacja może stworzyć:
prawdziwe błędne zamówienie.
---
12. Automatyzacja dokumentów HR
Możliwe przykłady:
CV,
wnioski,
formularze onboardingowe,
dokumenty pracownicze.
System może:
klasyfikować,
sprawdzać kompletność,
wydobywać wybrane dane,
przypisywać do sprawy.
Ale procesy dotyczące:
zatrudnienia
i:
oceny ludzi
wymagają szczególnej ostrożności.
Nie warto budować systemu, w którym AI samodzielnie:
podejmuje istotne decyzje personalne
na podstawie:
nieprzejrzystej oceny dokumentu.
---
13. Automatyzacja dokumentów magazynowych i logistycznych
Dokumenty WZ.
PZ.
Listy przewozowe.
Protokoły.
Potwierdzenia.
System może:
odczytać numer,
powiązać zamówienie,
sprawdzić ilości,
zapisać datę,
wskazać różnicę.
Im bardziej dane są:
powtarzalne,
tym większy potencjał automatyzacji.
---
14. Automatyzacja protokołów i raportów serwisowych
Technik kończy wizytę.
Powstaje:
albo:
formularz.
AI może wyciągnąć:
klienta,
urządzenie,
problem,
wykonane czynności,
części,
rekomendacje.
CRM może automatycznie dostać:
notatkę.
ERP:
zużyte części.
System:
termin kolejnego serwisu.
Jeden dokument uruchamia:
kilka procesów.
---
15. Automatyczne tworzenie dokumentów
Automatyzacja działa również:
w drugą stronę.
Nie tylko:
dokument → dane.
Ale:
dane → dokument.
Przykład:
CRM → dane klienta → szablon → oferta PDF. ERP → dane zamówienia → potwierdzenie.
Formularz → dane → umowa.
---
Dokument powinien powstawać z systemu, a nie z kopiowania
Przykład ręczny:
otwórz starą ofertę.
Zapisz jako.
Zmień klienta.
Zmień cenę.
Zmień datę.
Usuń stare dane.
Przypadkiem pozostaje:
nazwisko poprzedniego klienta.
Znacznie lepszy model:
CRM + cennik + zatwierdzony template → dokument
Mniej:
kopiowania.
Mniej:
błędów.
---
AI może przygotować treść, ale dane krytyczne powinny pochodzić z systemów
Oferta:
opis problemu → AI.
Rekomendowane rozwiązanie → AI + template.
Ale:
nazwa klienta → CRM.
cena → cennik.
NIP → baza.
termin → projekt / człowiek.
warunki płatności → zatwierdzony standard.
Zasada:
AI generuje język. System dostarcza fakty.
---
Jak wygląda techniczny pipeline Document AI?
Przykładowo:
trigger
↓
file ingestion
↓
virus / format checks
↓
OCR / native parsing
↓
document classification
↓
field extraction
↓
normalization
↓
business validation
↓
confidence / exception check
↓
human review
↓
ERP / CRM / DMS
↓
workflow
↓
logging
To bardzo różni się od:
„wyślij PDF do ChatGPT i poproś o JSON”.
---
Czy można po prostu wysłać PDF do modelu multimodalnego?
Technicznie:
często tak.
Nowoczesne foundation models potrafią pracować bezpośrednio z:
PDF,
obrazem,
skanem.
AWS w aktualnych wytycznych dotyczących IDP rozróżnia dwa podejścia:
tradycyjny pipeline — OCR/document understanding + model do dalszej interpretacji,
oraz:
bezpośrednie przetwarzanie multimodalne przez foundation model.
AWS wskazuje, że klasyczne pipeline’y są szczególnie przydatne przy dużej skali i tam, gdzie potrzebna jest precyzyjna kontrola, podczas gdy modele multimodalne mogą upraszczać część architektury.
Nie istnieje więc jedna architektura:
najlepsza zawsze.
---
Kiedy klasyczny OCR / parser jest lepszy?
Gdy:
dokumentów jest bardzo dużo,
pola są jasno określone,
potrzebujesz przewidywalnego JSON,
proces jest stabilny,
ważny jest koszt jednostkowy,
potrzebujesz łatwej walidacji.
Przykład:
100 000 faktur.
---
Kiedy multimodalny LLM może być bardzo użyteczny?
Gdy:
dokumenty są mocno zróżnicowane,
ważny jest kontekst,
pytanie nie ogranicza się do pól,
trzeba analizować:
całe fragmenty,
klauzule,
zależności.
Przykład:
umowy
albo:
zapytania ofertowe.
---
Często najlepszy jest model hybrydowy
Faktura:
parser.
Umowa:
LLM.
Walidacja kwot:
reguła.
Mapowanie produktu:
baza.
Stworzenie podsumowania:
AI.
Zapis do ERP:
automatyzacja.
Finalna akceptacja:
człowiek.
Nie ma potrzeby, aby:
jeden model
robił:
wszystko.
---
Confidence score nie jest decyzją biznesową
Model zwraca:
96% confidence.
Czy dokument można:
automatycznie zaksięgować?
To zależy.
Pole:
nazwa ulicy
błędne przy:
96%
może nie mieć dużego znaczenia.
Pole:
kwota:
96%
może być nieakceptowalne.
Dlatego próg review powinien zależeć od:
pola i konsekwencji błędu.
---
Walidacja biznesowa jest często ważniejsza niż confidence AI
Faktura:
model jest pewny:
99%.
Kwota:
12 300 zł.
Ale PO wynosi:
10 000 zł.
System powinien:
zatrzymać dokument.
Dlaczego?
Bo:
dane są niespójne biznesowo.
Nie interesuje nas tylko:
czy AI dobrze przeczytało cyfrę.
Interesuje:
czy dokument ma sens w procesie.
---
Cztery poziomy walidacji
1. Techniczna
Czy mamy poprawny JSON?
Czy pole istnieje?
2. Matematyczna
Netto + VAT = brutto?
Suma pozycji = total?
3. Referencyjna
Czy dostawca istnieje?
Czy PO istnieje?
Czy produkt istnieje?
4. Biznesowa
Czy kwota mieści się w tolerancji?
Czy ta osoba może zatwierdzić?
Czy termin jest dopuszczalny?
Najlepszy document automation łączy:
AI + reguły + dane systemowe.
---
Human-in-the-loop w dokumentach
Nie każdy dokument powinien być:
ręcznie kontrolowany.
Ale też nie każdy powinien:
przejść automatycznie.
Przykład.
1000 faktur.
850
Standardowe.
Dane zgodne.
Przechodzą automatycznie.
100
Niski confidence.
Review.
35
Brak PO.
Review.
15
Duża różnica wartości.
Eskalacja.
Człowiek kontroluje:
150.
Nie:
1000.
To jest:
management by exception.
---
Celem nie musi być 100% straight-through processing
Firma mówi:
„Chcemy automatyzować wszystko”.
Po co?
Jeżeli:
80% przypadków
jest prostych,
a ostatnie:
20%
generuje 80% złożoności,
bardzo dobrym wynikiem może być:
automatyczna obsługa większości
i:
dobry proces wyjątku.
Nie warto wydawać ogromnego budżetu tylko po to, aby:
ostatnie kilka procent
również nie dotknęło człowieka.
---
Automatyzacja dokumentów a jakość danych
AI może przeczytać dokument.
Ale jeżeli system docelowy posiada:
złe dane referencyjne,
problemy pozostają.
Przykład:
dostawca istnieje:
3 razy.
ERP posiada:
nieaktualne konto.
Produkty:
bez standardowych kodów.
Automatyzacja dokumentów często ujawnia:
problem master data.
To dobrze.
Lepiej go zobaczyć niż:
automatycznie powielać.
---
Duplikaty dokumentów
To szczególnie ważne przy:
fakturach
i:
zamówieniach.
Dokument może przyjść:
e-mailem.
Później:
ponownie.
Albo:
KSeF + e-mail.
System powinien rozpoznać:
że to:
ten sam dokument.
Możliwe identyfikatory:
numer,
dostawca,
data,
kwota,
KSeF ID,
hash pliku.
Bez deduplikacji można:
utworzyć podwójny rekord
albo gorzej:
podwójną płatność.
---
Dokument może przyjść kilkoma kanałami
To ważne po KSeF.
Faktura istnieje w:
KSeF.
Dostawca dodatkowo wysyła:
PDF e-mailem.
Jeżeli dwa workflow działają niezależnie:
powstają:
dwa dokumenty.
Dlatego automatyzacja powinna mieć:
jeden logiczny proces,
nawet jeżeli istnieje:
kilka źródeł wejścia.
---
Archiwizacja to część procesu
Po przetworzeniu trzeba zdecydować:
gdzie dokument trafia.
DMS?
SharePoint?
Drive?
ERP?
Dedykowane archiwum?
Nie warto tworzyć systemu:
plik w jednym miejscu, dane w drugim, brak połączenia.
Rekord powinien pozwalać odnaleźć:
oryginalny dokument.
---
Nazewnictwo dokumentów może być automatyczne
Zamiast:
`scan000342_final2.pdf`
system może zapisać:
`2026-09-15_FV-234_ABC-Sp-z-o-o_12300-PLN.pdf`
Ale nawet nazwa pliku nie powinna być:
główną bazą danych.
Dane powinny istnieć jako:
metadata.
Plik:
to dokument źródłowy.
---
Automatyczne tagowanie dokumentów
Możliwe pola:
typ,
firma,
rok,
projekt,
dział,
status,
owner,
data,
kategoria.
Dzięki temu dokument można znaleźć po:
danych.
Nie tylko:
folderze.
---
Dokumenty mogą zasilać bazę wiedzy AI
Instrukcje.
Procedury.
Polityki.
Umowy wzorcowe.
Materiały produktowe.
Po przetworzeniu można zbudować:
wyszukiwarkę semantyczną
albo:
asystenta RAG.
Ale przed wrzuceniem:
20 000 dokumentów
warto sprawdzić:
aktualność,
duplikaty,
uprawnienia,
wersje.
Nie każda firma potrzebuje:
„RAG na całym Drive”.
---
Dokument AI nie powinien widzieć wszystkiego
Pracownik działu sprzedaży:
nie musi mieć dostępu do:
dokumentów HR.
Agent ofertowy:
nie potrzebuje:
akt osobowych.
System powinien dziedziczyć:
zasady uprawnień.
Nie tworzyć:
jednej wielkiej puli dokumentów dla AI.
---
Dane osobowe i dokumenty
Dokumenty mogą zawierać:
adresy,
PESEL,
wynagrodzenia,
dane finansowe,
dane pracowników,
dane klientów.
Dlatego projekt powinien ustalić:
które dane są potrzebne,
gdzie są wysyłane,
gdzie są przechowywane,
kto ma dostęp,
co trafia do logów,
jak długo dane są przechowywane.
Zasada:
minimum danych potrzebnych do celu.
---
Logi mogą być nowym miejscem wycieku danych
Automatyzacja działa świetnie.
Developer loguje:
cały input.
Czyli:
pełne umowy,
faktury,
dane klientów,
CV.
Log służy:
debugowaniu.
Ale staje się:
kopią dokumentacji firmy.
Dlatego observability trzeba projektować razem z:
prywatnością.
---
E-mail z załącznikiem jest potencjalnie niezaufanym wejściem
To ważne przy wykorzystaniu LLM.
Zewnętrzny dokument może zawierać:
tekst wyglądający jak instrukcja dla modelu.
Dlatego:
treść klienta
i:
treść PDF-a
należy traktować jako:
dane wejściowe,
nie:
instrukcje systemowe.
Jest to szczególnie ważne, jeżeli AI ma później możliwość:
wysyłania e-maili,
zmieniania danych,
wykonywania operacji w systemach.
---
Agent dokumentowy powinien mieć minimalne uprawnienia
Agent od faktur może:
odczytać dokument,
sprawdzić dostawcę,
utworzyć draft rekordu.
Nie musi:
sam wykonywać przelewu.
Agent od umów może:
utworzyć zadanie.
Nie musi:
podpisywać kontraktu.
AI może mieć:
dużą autonomię interpretacyjną
i:
bardzo ograniczoną autonomię wykonawczą.
To często dobry kompromis.
---
Jak mierzyć automatyzację dokumentów?
Nie tylko:
accuracy OCR.
Potrzebujesz:
wskaźników procesu.
Volume
Ile dokumentów?
Processing time
Ile trwa jeden przypadek?
Straight-through processing rate
Jaki procent przechodzi bez człowieka?
Exception rate
Ile trafia do review?
Field accuracy
Czy pola są prawidłowe?
Human correction rate
Jak często pracownik poprawia system?
Cost per document
Ile kosztuje jeden dokument?
Lead time
Ile czasu od otrzymania do zakończenia procesu?
Duplicate rate
Ile duplikatów wykryto?
SLA
Czy dokumenty są obsłużone na czas?
---
Accuracy 99% może być gorsze niż brzmi
Załóżmy:
faktura ma:
20 ważnych pól.
Każde pole:
99% accuracy.
To nie oznacza automatycznie:
99% dokumentów bez błędu.
Przy wielu polach prawdopodobieństwo przynajmniej jednej pomyłki w całym dokumencie może być:
znacznie większe.
Dlatego przy automatyzacji dokumentów warto mierzyć:
document-level success rate
obok:
field-level accuracy.
---
Lepsza metryka: koszt poprawnie przetworzonego dokumentu
System A:
0,20 zł / dokument.
Ale:
20% wymaga review.
System B:
0,60 zł.
Tylko:
2% review.
Który jest:
tańszy?
Nie wiadomo bez kosztu człowieka.
Dlatego licz:
system + human review + rework.
Nie tylko:
API.
---
Przykładowe ROI automatyzacji dokumentów
Przykład hipotetyczny.
Firma przetwarza:
1500 dokumentów miesięcznie.
Ręcznie:
4 minuty każdy.
Łącznie:
100 godzin.
Po wdrożeniu:
80% dokumentów przechodzi automatycznie.
20%:
wymaga średnio 2 minut review.
300 × 2 min =
600 minut.
Czyli:
10 godzin.
Różnica:
90 godzin miesięcznie.
Koszt godziny:
60 zł.
Teoretyczna wartość capacity:
5400 zł miesięcznie.
Ale nie oznacza to jeszcze:
5400 zł gotówkowej oszczędności.
Firma może:
uniknąć dodatkowego etatu,
ograniczyć outsourcing,
obsłużyć większy wolumen.
To właśnie wtedy capacity zamienia się w:
wartość ekonomiczną.
---
Automatyzacja dokumentów może mieć bardzo krótki payback
Szczególnie przy:
dużym wolumenie,
ręcznym przepisywaniu,
prostych dokumentach.
Ale może również:
nie mieć sensu.
Firma otrzymuje:
10 umów miesięcznie.
Każda wymaga:
5 minut administracji.
Budowa systemu:
50 000 zł.
Jeżeli nie istnieją inne korzyści:
business case może być słaby.
Dlatego automatyzujemy:
proces o wartości.
Nie dokument tylko dlatego, że:
jest PDF-em.
---
Kiedy automatyzacja dokumentów jest dobrym kandydatem?
Szczególnie gdy:
- dokumentów jest dużo,
- dane są przepisywane ręcznie,
- dokumenty mają podobne klasy,
- występują jasno określone pola,
- trzeba wprowadzać dane do kolejnego systemu,
- błędy mają mierzalny koszt,
- proces ma określone SLA,
- występują powtarzalne decyzje,
- dokument uruchamia kolejne działania.
---
Kiedy nie zaczynać od AI?
Dokumentów jest bardzo mało
Automatyzacja może się nie zwrócić.
Dane już istnieją w API
Nie używaj OCR bez potrzeby.
Problemem nie jest odczyt
Tylko:
brak procesu approval.
Każdy dokument jest całkowicie inny
A rezultat wymaga:
eksperckiej interpretacji.
AI może pomóc:
ale pełna automatyzacja może być trudna.
Firma nie wie, co dalej robi z dokumentem
Najpierw:
proces.
---
Największy błąd: automatyzować tylko ekstrakcję
Firma wdraża:
AI do faktur.
AI odczytuje:
dane.
Pracownik kopiuje wynik:
z panelu AI
do:
ERP.
Czy proces został zautomatyzowany?
Tylko częściowo.
Największa wartość pojawia się, gdy:
dokument → dane → system
działa jako:
jeden workflow.
---
Drugi błąd: automatyzować stary chaos
Firma posiada:
folder:
`Faktury nowe`
`Faktury do sprawdzenia`
`Faktury nowe2`
`Faktury_final`
`Faktury_do_Kasi`
Automatyzacja może połączyć:
wszystkie.
Ale może też:
utrwalić chaos.
Najpierw ustal:
stany procesu.
---
Przykładowy proces dokumentu
Received
Dokument otrzymany.
Classified
Typ rozpoznany.
Extracted
Dane wydobyte.
Validation failed
Wymaga review.
Approved
Zatwierdzony.
Posted
Zapisany do systemu.
Archived
Zakończony.
To znacznie lepsze niż:
10 folderów.
---
Trzeci błąd: brak mechanizmu wyjątków
Co jeśli:
PDF jest zabezpieczony?
Brakuje strony?
OCR nie działa?
Nie ma numeru zamówienia?
Dostawca nie istnieje?
Kwota się nie zgadza?
API ERP nie działa?
System musi wiedzieć:
co wtedy.
---
Czwarty błąd: brak idempotencji
Dokument został wysłany:
dwa razy.
Workflow uruchamia się:
dwa razy.
Czy utworzymy:
dwa rekordy?
Dwa zamówienia?
Dwie faktury?
Dwie płatności?
System powinien potrafić rozpoznać:
już przetworzone.
---
Piąty błąd: AI tworzy fakty, których nie ma w dokumencie
Brakuje:
terminu.
Model „domyśla się”:
30 dni.
Nie.
Jeżeli pola nie ma:
wartość:
`null`
albo:
review.
Brak danych jest informacją.
Nie problemem, który AI ma kreatywnie rozwiązać.
---
Szósty błąd: każdy dokument musi być zautomatyzowany w 100%
Nie.
Możesz zautomatyzować:
80%.
I mieć świetny ROI.
Reszta:
human review.
Celem nie jest:
wyeliminować człowieka.
Celem:
usunąć ręczną pracę tam, gdzie nie wnosi wartości.
---
Jak wdrożyć automatyzację dokumentów krok po kroku?
Krok 1. Wybierz jeden typ dokumentu
Nie:
„wszystkie dokumenty firmy”.
Na przykład:
faktury kosztowe.
Krok 2. Zbierz próbkę
50–200 prawdziwych przykładów.
Różne:
formaty,
dostawcy,
jakość.
Krok 3. Zmapuj current state
Skąd przychodzą?
Kto je otwiera?
Co przepisuje?
Gdzie zapisuje?
Krok 4. Określ pola
Których danych naprawdę potrzebujesz?
Krok 5. Określ źródło danych
API?
XML?
PDF?
E-mail?
Krok 6. Wybierz metodę ekstrakcji
Reguła?
Parser?
OCR?
AI multimodalne?
Krok 7. Zaprojektuj walidację
Matematyka.
System referencyjny.
Reguły biznesowe.
Krok 8. Zdefiniuj wyjątki
Kiedy człowiek?
Krok 9. Zintegruj system docelowy
ERP.
CRM.
DMS.
Krok 10. Uruchom pilot
Na realnym wolumenie.
Krok 11. Mierz correction rate
Nie tylko accuracy na demo.
Krok 12. Skaluj
Kolejni dostawcy.
Kolejne dokumenty.
Kolejne procesy.
---
Jaką technologię wybrać?
Nie zaczynałbym od:
„OpenAI czy Gemini?”
Najpierw:
typ dokumentu.
Faktura z KSeF
API / dane strukturalne.
Faktura spoza KSeF
Prebuilt invoice parser może mieć sens.
Standardowy formularz
OCR / form parser.
Umowa
Layout + generatywna ekstrakcja + review.
Zapytanie ofertowe
LLM / multimodal AI + schema.
Tabela
Parser layoutu / tabel.
Jeden stały szablon
Prosta ekstrakcja może wystarczyć.
Technologia powinna wynikać z:
dokumentu i procesu.
---
Make, n8n czy Zapier przy dokumentach?
Każde może pełnić rolę:
orkiestratora.
Workflow może wyglądać:
e-mail → Make / n8n / Zapier → Document AI → walidacja → ERP
Ale wybór zależy od:
wolumenu,
integracji,
hostingu,
złożoności.
Nie warto wybierać narzędzia tylko na podstawie:
tego, które jest obecnie popularne.
---
Dedykowany Document AI czy zwykły LLM?
Document AI
Mocny przy:
poważnej ekstrakcji,
stałym schemacie danych,
dużym wolumenie,
potrzebie confidence,
layout,
tabele.
LLM
Mocny przy:
znaczeniu,
podsumowaniu,
umowach,
zróżnicowanych dokumentach,
nietypowych pytaniach.
Hybryda
Bardzo często:
najlepsza.
---
Aktualne platformy potrafią znacznie więcej niż klasyczny OCR
Google Document AI posiada między innymi:
Enterprise OCR,
Form Parser,
Layout Parser,
Invoice Parser,
Custom Extractor,
Custom Classifier.
Jego Layout Parser potrafi analizować tekst, tabele i listy oraz przygotowywać kontekstowe fragmenty do zastosowań generatywnych.
W 2026 roku Google rozwija również custom extractors oparte na nowszych modelach generatywnych oraz funkcje walidacji dokumentów.
Microsoft Document Intelligence obsługuje między innymi:
layout,
faktury,
dokumenty,
formularze,
custom extraction
oraz modele kontraktowe.
AWS Textract obsługuje tekst, formularze, tabele, query responses, podpisy oraz specjalistyczną analizę faktur i rachunków.
Nie oznacza to, że któraś z tych platform jest:
zawsze najlepsza.
Pokazuje natomiast, że nowoczesna automatyzacja dokumentów nie ogranicza się już do:
OCR znaków.
---
Jak ExperciAI podchodzi do automatyzacji dokumentów?
Nie zaczynamy od:
„wrzućmy PDF do AI”.
Najpierw analizujemy:
skąd dokument przychodzi,
co to za dokument,
które informacje są potrzebne,
co pracownik robi z nimi dzisiaj,
gdzie dane trafiają,
jak wyglądają wyjątki,
które decyzje można zautomatyzować.
Później dzielimy proces.
Źródła strukturalne
Jeżeli istnieje:
API,
XML,
KSeF,
wykorzystujemy strukturę.
OCR / parser
Tam, gdzie trzeba:
odczytać dokument.
AI
Tam, gdzie trzeba:
zrozumieć kontekst,
wydobyć niejednoznaczne informacje,
podsumować,
klasyfikować.
Reguły
Tam, gdzie trzeba:
sprawdzić wartości.
Automatyzacja
Tam, gdzie dane trzeba:
przenieść,
zapisać,
uruchomić kolejny krok.
Człowiek
Tam, gdzie występuje:
wyjątek,
niska pewność,
wysokie ryzyko,
decyzja.
Jeżeli przed automatyzacją trzeba uporządkować przepływ dokumentów:
https://experciai.pl/oferta/audyt-procesow-w-firmie/
Jeżeli proces jest już znany i trzeba połączyć e-mail, dokumenty, AI, ERP lub CRM:
https://experciai.pl/oferta/automatyzacja-procesow/
---
Checklista automatyzacji dokumentów
Proces
- Jaki dokument automatyzujemy?
- Ile dokumentów miesięcznie?
- Skąd przychodzą?
- Kto je obsługuje?
- Ile czasu zajmuje jeden dokument?
- Gdzie dziś przepisywane są dane?
- Co dzieje się po przepisaniu?
Źródło
- Czy dane istnieją już w API?
- Czy dokument ma warstwę tekstową?
- Czy potrzebujemy OCR?
- Czy istnieje KSeF lub inny system strukturalny?
- Czy plik zawiera kilka dokumentów?
Klasyfikacja
- Czy znamy wszystkie typy dokumentów?
- Czy dokument może zostać błędnie sklasyfikowany?
- Co robimy z klasą „inne”?
Ekstrakcja
- Jakich pól potrzebujemy?
- Które są krytyczne?
- Które mogą pozostać puste?
- Czy potrzebujemy tabel?
- Czy potrzebujemy danych z wielu stron?
- Czy potrzebujemy rozumienia klauzul?
Walidacja
- Czy można sprawdzić sumy?
- Czy dane można porównać z ERP?
- Czy istnieje system referencyjny?
- Czy wykrywamy duplikaty?
- Czy kontrolujemy tolerancję różnic?
- Czy wiemy, kiedy system ma zatrzymać dokument?
AI
- Czy AI jest rzeczywiście potrzebne?
- Czy wystarcza klasyczny parser?
- Czy model ma zwracać structured output?
- Czy brak wartości zwraca jako brak, zamiast zgadywać?
- Czy mierzymy correction rate?
- Czy rozróżniamy fakty od wniosków AI?
Human review
- Które pola wymagają kontroli?
- Jaki confidence wymaga review?
- Czy próg zależy od pola?
- Kto obsługuje wyjątki?
- Czy pracownik widzi dokument i dane obok siebie?
Integracja
- Gdzie dane trafiają?
- Czy system ma API?
- Czy utworzenie rekordu może się powtórzyć?
- Czy workflow jest idempotentny?
- Czy awaria API generuje retry?
- Czy istnieje alert?
Bezpieczeństwo
- Jakie dane są przetwarzane?
- Gdzie pliki są wysyłane?
- Co trafia do logów?
- Kto ma dostęp?
- Jak długo dane są przechowywane?
- Czy agent posiada tylko niezbędne uprawnienia?
Pomiar
- Ile dokumentów przechodzi automatycznie?
- Ile wymaga review?
- Jaki jest correction rate?
- Jaki jest document-level success rate?
- Jaki jest czas przetwarzania?
- Jaki jest koszt jednego dokumentu?
- Czy liczba błędów spadła?
- Czy lead time spadł?
- Czy proces mieści się w SLA?
- Czy automatyzacja ma dodatni business case?
Jeżeli odpowiedzi na dużą część pytań nie są znane:
warto najpierw:
zmapować proces.
---
FAQ — automatyzacja dokumentów w firmie
Co to jest automatyzacja dokumentów?
To automatyczne przyjmowanie, rozpoznawanie, odczytywanie, klasyfikowanie, walidowanie i przekazywanie danych z dokumentów do kolejnych systemów lub procesów.
Co to jest IDP?
Intelligent Document Processing to wykorzystanie OCR, machine learning, NLP i AI do zamiany nieustrukturyzowanych dokumentów w dane wykorzystywane przez systemy biznesowe.
Czym IDP różni się od OCR?
OCR przede wszystkim rozpoznaje tekst. IDP może dodatkowo klasyfikować dokument, rozpoznawać jego strukturę, wydobywać pola, walidować dane i uruchamiać kolejne procesy.
Czy AI potrafi czytać PDF?
Tak. Nowoczesne systemy mogą analizować cyfrowe PDF-y oraz zeskanowane dokumenty, choć sposób przetwarzania powinien zależeć od typu i jakości pliku.
Czy każdy PDF wymaga OCR?
Nie. Cyfrowy PDF może już posiadać warstwę tekstową. OCR jest szczególnie potrzebny przy skanach i obrazach.
Czy AI może odczytywać faktury?
Tak. Istnieją gotowe modele dokumentowe potrafiące wydobywać między innymi numer faktury, datę, dostawcę, kwoty i pozycje.
Czy faktury w Polsce warto odczytywać OCR-em?
Nie zawsze. Jeżeli faktura jest dostępna jako ustrukturyzowany dokument poprzez KSeF, wykorzystanie danych KSeF może być lepszym rozwiązaniem niż ponowne odczytywanie PDF-a OCR-em.
Od kiedy KSeF jest obowiązkowy?
Duzi podatnicy zostali objęci obowiązkiem wystawiania od 1 lutego 2026 roku, większość pozostałych od 1 kwietnia 2026 roku, a najmniejsze podmioty objęte przejściowym wyjątkiem mają wejść do systemu 1 stycznia 2027 roku. Odbieranie faktur przez KSeF jest obowiązkowe od 1 lutego 2026 roku.
Czy KSeF ma API?
Tak. Ministerstwo Finansów udostępnia dokumentację API KSeF 2.0 opartą na OpenAPI, przeznaczoną do integracji systemów z KSeF.
Czy można automatycznie księgować faktury?
Technicznie można automatyzować znaczną część procesu, ale poziom autonomii powinien zależeć od walidacji, wyjątków, ryzyka i zasad księgowych firmy.
Czy AI może analizować umowy?
Tak. Może wydobywać strony, terminy, warunki, kluczowe klauzule i przygotowywać podsumowania. Interpretacje wymagające odpowiedzialności prawnej powinny być odpowiednio weryfikowane.
Czy AI może porównywać dwie umowy?
Tak. Może wskazać różnice pomiędzy wersjami i przygotować checklistę zmian do review.
Czy AI może generować oferty?
Może przygotować draft na podstawie danych i zatwierdzonych źródeł. Krytyczne dane takie jak cena, termin i warunki powinny pochodzić z właściwych systemów lub decyzji człowieka.
Czy można automatyzować e-maile z załącznikami?
Tak. System może analizować treść e-maila, pobierać załączniki, klasyfikować dokumenty, wydobywać dane i przekazywać je do właściwego procesu.
Co jeśli PDF zawiera kilka dokumentów?
Można wykorzystać document splitting i classification, aby rozdzielić plik na logiczne dokumenty przed dalszym przetwarzaniem.
Czy AI potrafi czytać tabele?
Tak. Wyspecjalizowane narzędzia document AI potrafią analizować strukturę tabel i zwracać wiersze, kolumny oraz komórki.
Co jeśli AI źle odczyta dokument?
Workflow powinien posiadać walidację oraz mechanizm human review dla przypadków o niskiej pewności lub niespójnych danych.
Co to jest straight-through processing?
To odsetek dokumentów, które przechodzą cały proces bez ręcznej interwencji.
Czy celem powinno być 100% automatyzacji?
Nie. Często bardziej opłacalne jest automatyczne obsłużenie większości typowych dokumentów i przekazywanie wyjątków człowiekowi.
Jak mierzyć skuteczność Document AI?
Można mierzyć field accuracy, document-level success rate, human correction rate, exception rate, straight-through processing rate, czas i koszt na dokument.
Czy automatyzacja dokumentów wymaga agenta AI?
Nie. Wiele procesów można zbudować jako klasyczny workflow z OCR, parserem, regułami i integracjami. Agent ma sens przy bardziej dynamicznych procesach.
Czy Make lub n8n może automatyzować dokumenty?
Tak. Mogą pełnić rolę orkiestratora pomiędzy e-mailem, usługą Document AI, ERP, CRM, bazą danych i innymi narzędziami.
Ile kosztuje automatyzacja dokumentów?
Zależy od wolumenu, liczby typów dokumentów, sposobu ekstrakcji, integracji, wymagań walidacji i poziomu autonomii. Najlepiej policzyć koszt na jeden poprawnie obsłużony dokument.
Kiedy automatyzacja dokumentów się opłaca?
Najczęściej przy dużym wolumenie, powtarzalnej ręcznej pracy, jasno określonym procesie, dostępnych integracjach i mierzalnym koszcie obecnej obsługi.
Od czego zacząć?
Od jednego typu dokumentu występującego często i prześledzenia jego drogi od otrzymania do zakończenia procesu.
---
Podsumowanie
Automatyzacja dokumentów nie polega na:
„AI czyta PDF”.
To tylko:
początek.
Prawdziwy proces wygląda:
wejście → klasyfikacja → ekstrakcja → walidacja → system → działanie → archiwizacja.
Dla:
faktury
system może sprawdzić:
kwoty,
dostawcę,
zamówienie
i:
ERP.
Dla:
umowy
może znaleźć:
strony,
terminy,
klauzule
i:
utworzyć przypomnienia.
Dla:
zapytania ofertowego
może:
wydobyć wymagania,
deadline,
załączniki,
utworzyć opportunity
i:
zadania.
Dla:
e-maila
może:
zrozumieć treść,
pobrać dokument,
rozpoznać typ
i:
wysłać go do właściwego procesu.
Najważniejsza zasada:
nie używaj AI tam, gdzie istnieje lepsze źródło danych.
Jeżeli faktura istnieje:
w KSeF,
wykorzystaj KSeF.
Jeżeli pole istnieje:
w API,
wykorzystaj API.
Jeżeli dokument posiada:
natywny tekst,
nie rób OCR bez potrzeby.
AI powinno pojawić się tam, gdzie firma naprawdę potrzebuje:
rozumienia nieustrukturyzowanej informacji.
Potem:
reguły sprawdzają.
Automatyzacja wykonuje.
Systemy przechowują.
Człowiek przejmuje:
wyjątki.
To jest różnica między:
OCR-em
a:
automatyzacją dokumentów w firmie.
Jeżeli trzeba najpierw znaleźć i uporządkować ręczny obieg dokumentów:
https://experciai.pl/oferta/audyt-procesow-w-firmie/
Jeżeli proces jest już określony i trzeba połączyć e-mail, PDF-y, AI, KSeF, CRM lub ERP:
https://experciai.pl/oferta/automatyzacja-procesow/
Źródła i dokumentacja
1. Google Cloud — Document AI overview
Oficjalna dokumentacja platformy Document AI. Opisuje przekształcanie nieustrukturyzowanych dokumentów w dane strukturalne oraz OCR, ekstrakcję, klasyfikację i splitting dokumentów.
https://cloud.google.com/document-ai/docs/overview
2. Google Cloud — Document AI processor list
Dokumentacja aktualnych procesorów Document AI, w tym Enterprise OCR, Form Parser, Layout Parser, Invoice Parser, Custom Extractor i Custom Classifier.
https://docs.cloud.google.com/document-ai/docs/processors-list
3. Google Cloud — Document AI Workbench
Dokumentacja ekstrakcji danych z dokumentów ustrukturyzowanych i nieustrukturyzowanych przy użyciu generatywnego AI i custom extractorów.
https://cloud.google.com/document-ai-workbench
4. Google Cloud — Document AI release notes
Aktualne informacje o zmianach platformy w 2026 roku, w tym nowszych custom extractorach i mechanizmach walidacji.
https://docs.cloud.google.com/document-ai/docs/release-notes
5. Microsoft — Document Intelligence models
Oficjalny przegląd modeli Azure Document Intelligence, w tym layout, invoice, receipt oraz custom extraction.
https://learn.microsoft.com/en-us/azure/ai-services/document-intelligence/model-overview
6. Microsoft — Invoice data extraction
Dokumentacja modelu przeznaczonego do przetwarzania faktur i ekstrakcji pól oraz pozycji dokumentu.
https://learn.microsoft.com/pl-pl/azure/ai-services/document-intelligence/prebuilt/invoice
7. Microsoft — Contract data extraction
Dokumentacja modelu kontraktowego Azure Document Intelligence służącego do wydobywania wybranych danych z umów.
https://learn.microsoft.com/en-us/azure/ai-services/document-intelligence/prebuilt/contract
8. Microsoft — Structured and freeform document processing
Dokumentacja rozróżniająca przetwarzanie dokumentów ustrukturyzowanych i półustrukturyzowanych od dokumentów freeform takich jak umowy i pisma.
https://learn.microsoft.com/en-us/microsoft-365/documentprocessing/form-processing-overview
9. AWS — Intelligent Document Processing
Oficjalny opis Intelligent Document Processing łączącego OCR, computer vision, NLP, ML oraz generatywne AI.
https://aws.amazon.com/ai/generative-ai/use-cases/document-processing/
10. AWS — Amazon Textract: invoices and receipts
Dokumentacja ekstrakcji danych z faktur i rachunków, m.in. numerów, dostawców, kwot, pozycji i terminów.
https://docs.aws.amazon.com/textract/latest/dg/invoices-receipts.html
11. AWS — Amazon Textract: document analysis
Dokumentacja analizy tekstu, formularzy, tabel, query responses i podpisów.
https://docs.aws.amazon.com/textract/latest/dg/how-it-works-analyzing.html
12. AWS — Intelligent document processing architecture patterns
Opis dwóch podejść do document processing: klasycznego pipeline’u OCR/document understanding oraz bezpośredniego wykorzystania modeli multimodalnych.
https://docs.aws.amazon.com/prescriptive-guidance/latest/strategy-enterprise-ready-gen-ai-platform/patterns.html
13. KSeF — zakres obowiązkowego KSeF
Oficjalne informacje Ministerstwa Finansów dotyczące terminów i zakresu obowiązkowego KSeF.
https://ksef.podatki.gov.pl/informacje-ogolne-ksef-20/zakres-obowiazkowego-ksef/
14. KSeF — etapy wdrożenia KSeF 2.0
Aktualna mapa drogowa wdrożenia KSeF, w tym obowiązek dla większości przedsiębiorców od 1 kwietnia 2026 roku i wejście najmniejszej grupy od 1 stycznia 2027 roku.
https://ksef.podatki.gov.pl/etapy-wdrozenia-ksef/
15. KSeF — dokumentacja dla integratorów
Oficjalna dokumentacja API KSeF 2.0, OpenAPI oraz materiały przeznaczone do integracji systemów finansowo-księgowych z KSeF.
https://ksef.podatki.gov.pl/ksef-na-okres-obligatoryjny/wsparcie-dla-integratorow/
16. KSeF — publikacja API KSeF 2.0 i struktury FA(3)
Informacje Ministerstwa Finansów dotyczące dokumentacji technicznej, struktury FA(3), API i narzędzi SDK do integracji.
https://ksef.podatki.gov.pl/wyjasnienia/publikacja-dokumentacji-api-ksef-20-oraz-struktury-logicznej-fa-3-30062025/
Następny krok
Przełóż wnioski z artykułu na konkretne działania w swojej firmie.
Opisz sytuację i cel, a wrócimy z rekomendacją najlepszego kierunku działania.
Porozmawiajmy
WordPress czy strona w kodzie? Co wybrać dla firmy
WordPress czy dedykowana strona internetowa? Porównujemy szybkość, SEO, bezpieczeństwo, integracje, koszty i skalowanie. Sprawdź, które rozwiązanie pasuje do Twojej firmy.
Czytaj więcej
Czy firma potrzebuje strony internetowej?
Czy firma nadal potrzebuje własnej strony internetowej? Zobacz, jak strona wspiera sprzedaż B2B, SEO, wiarygodność, dane i pozyskiwanie klientów.
Czytaj więcej
Automatyzacja procesów w firmie: mniej chaosu i pilnowania
Automatyzacja procesów to nie tylko oszczędność czasu. Zobacz, jak zmniejsza liczbę rzeczy do pilnowania, porządkuje pracę i ogranicza chaos operacyjny.
Czytaj więcej